Embedding AI: Cara Mesin Memahami Makna Kata
Pahami apa itu embedding AI, cara kata diubah menjadi vektor yang menyimpan makna, dan perannya dalam pencarian semantik, RAG, serta rekomendasi pintar.
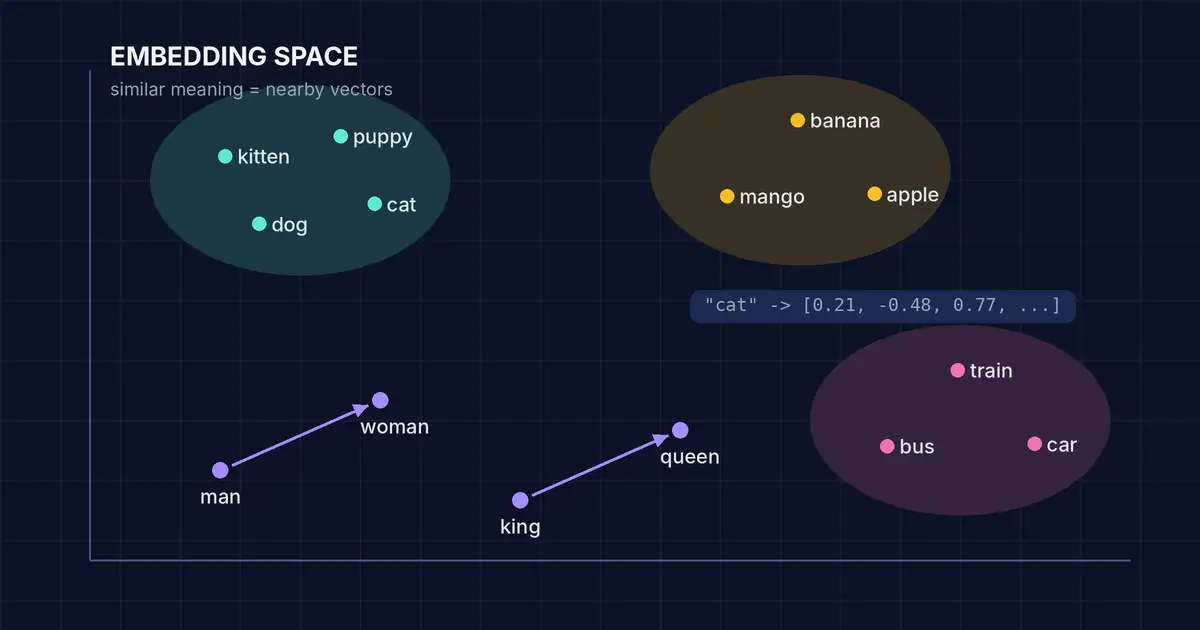
Cari "laptop murah" di mesin pencari yang pintar, dan hasil untuk "notebook terjangkau" juga ikut muncul, padahal kedua frasa itu tidak punya kata yang sama. Rahasia di baliknya bernama embedding. Embedding adalah salah satu fondasi AI modern yang jarang dibicarakan, dan begitu kamu memahaminya, banyak produk AI jadi lebih mudah dimengerti.
Apa itu embedding?
Embedding adalah deretan angka, disebut vektor, yang mewakili makna sebuah konten. Konten itu bisa berupa kata, kalimat, dokumen utuh, bahkan gambar.
Sebuah model membaca teks lalu menghasilkan sesuatu seperti [0.21, -0.48, 0.77, ...]. Embedding teks modern biasanya berisi ratusan hingga beberapa ribu angka. Satu angka saja tidak banyak artinya. Bersama-sama, angka-angka itu menempatkan teks di satu titik tertentu dalam "ruang makna" berdimensi tinggi.
Machine Learning Crash Course tentang embedding dari Google adalah pengantar visual yang bagus jika kamu ingin belajar lebih dalam.
Kenapa makna yang mirip letaknya berdekatan
Model embedding dilatih dengan teks dalam jumlah sangat besar. Model belajar bahwa kata yang muncul dalam konteks serupa cenderung punya makna serupa. Hasilnya, "kucing" dan "anak kucing" berada berdekatan, sedangkan "kucing" dan "faktur" letaknya berjauhan.
Contoh terkenal: king dan queen
Pada 2013, peneliti Google merilis Word2vec, salah satu metode embedding awal yang sangat berpengaruh. Word2vec menunjukkan hal yang mengejutkan: arah di dalam ruang vektor bisa membawa makna. Vektor "king" dikurangi "man" lalu ditambah "woman" menghasilkan titik yang sangat dekat dengan "queen".
Model masa kini jauh lebih canggih, tetapi gagasan intinya tetap sama. Makna berubah menjadi geometri.
Mengukur kedekatan
Untuk membandingkan dua embedding, sistem biasanya menghitung cosine similarity, yaitu seberapa searah dua vektor. Skor mendekati 1 berarti maknanya sangat mirip. Skor mendekati 0 berarti tidak berhubungan.
Di mana embedding digunakan
Pencarian semantik: menemukan hasil berdasarkan makna, bukan kata kunci yang persis sama.
RAG (Retrieval-Augmented Generation): chatbot mencari potongan paling relevan dari dokumenmu sebelum menjawab. Alur lengkapnya kami jelaskan di artikel apa itu RAG.
Rekomendasi: menyarankan artikel, produk, atau lagu yang mirip dengan yang sudah disukai pengguna.
Pengelompokan dan pelabelan: mengelompokkan ribuan tiket bantuan atau ulasan berdasarkan topik secara otomatis.
Deteksi duplikat: menemukan pertanyaan atau konten yang hampir sama meskipun ditulis dengan kata berbeda.
Tips memakai embedding
Gunakan model yang sama untuk semua yang dibandingkan. Vektor dari model berbeda berada di ruang yang berbeda, jadi mencampurnya menghasilkan skor yang tidak bermakna.
Pecah dokumen panjang menjadi potongan. Satu vektor untuk PDF 40 halaman membuat semua isinya kabur. Potongan beberapa paragraf biasanya jauh lebih akurat saat dicari.
Simpan vektor di indeks vektor. Untuk proyek kecil, array di memori sudah cukup. Untuk data yang lebih besar, ekstensi seperti pgvector memungkinkan pencarian vektor langsung di PostgreSQL.
Pilih model yang sesuai bahasa dan tugasmu. Leaderboard MTEB di Hugging Face membandingkan banyak model, termasuk model multibahasa yang mendukung bahasa Indonesia. Pilihan open-source tersedia lewat Sentence Transformers, sementara API seperti di panduan embedding OpenAI menunjukkan cara memulainya dalam beberapa baris kode.
Buat ulang embedding saat ganti model. Meng-upgrade model berarti semua vektor yang tersimpan harus dibuat ulang, jadi rencanakan sejak awal.
Embedding mengubah pertanyaan "apa artinya ini?" menjadi "seberapa jauh jarak titik-titik ini?"
Embedding bukan pemahaman
Embedding menangkap pola penggunaan kata, bukan pemahaman yang sesungguhnya. Embedding bisa mencerminkan bias dari data latihnya, dan dua kalimat bisa terlihat mirip padahal maknanya berlawanan, misalnya "tesnya lulus" dan "tesnya tidak lulus". Selalu uji hasilnya dengan contoh nyata dari datamu sendiri.
Jelajahi lebih lanjut
Embedding bekerja berdampingan dengan konsep AI dasar lainnya. Pelajari cara model memecah teks di panduan kami tentang token AI, pahami kenapa pencarian dokumen membantu mengurangi halusinasi AI, atau lihat proyek AI yang kami bangun di Ryuartistry.