Apa Itu RAG? Cara AI Menjawab dari Dokumen Sendiri
Apa itu RAG? Pelajari cara retrieval-augmented generation membuat AI menjawab dari dokumenmu sendiri, mengurangi halusinasi, dan tips membangun sistem RAG.
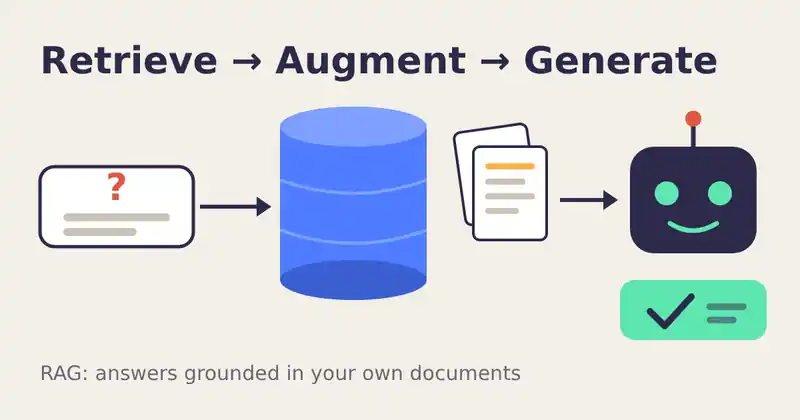
Model bahasa hanya tahu apa yang ia lihat saat dilatih. Ia belum pernah membaca manual produkmu, wiki perusahaanmu, atau daftar harga minggu lalu. Lalu bagaimana chatbot layanan pelanggan bisa menjawab pertanyaan tentang hal yang bersifat pribadi atau baru saja terjadi? Sebagian besar memakai teknik bernama RAG, singkatan dari retrieval-augmented generation.
Apa arti RAG
Istilah ini berasal dari makalah riset tahun 2020 berjudul Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks karya Patrick Lewis dan rekan-rekannya. Idenya sederhana: sebelum model menulis jawaban, sistem lebih dulu mengambil (retrieve) potongan teks yang relevan dari sumber tepercaya, lalu menambahkannya (augment) ke dalam prompt, dan akhirnya membiarkan model menghasilkan (generate) jawaban berdasarkan potongan itu.
Bayangkan seperti ujian open book. Model tetap yang menulis jawabannya, tetapi ia boleh membuka halaman yang tepat terlebih dahulu.
Cara kerja pipeline RAG
1. Siapkan basis pengetahuan
Dokumen dipecah menjadi bagian kecil yang disebut chunk, biasanya beberapa ratus kata. Setiap chunk diubah menjadi embedding, yaitu deretan angka yang mewakili maknanya. Panduan embeddings dari OpenAI memberi pengantar yang jelas tentang cara vektor ini mengukur kemiripan. Vektor tersebut lalu disimpan di vector database atau indeks pencarian.
2. Ambil (retrieve)
Saat pengguna bertanya, pertanyaannya diubah menjadi embedding dengan cara yang sama. Sistem mencari chunk yang vektornya paling dekat maknanya, lalu memilih beberapa hasil teratas.
3. Tambahkan dan hasilkan
Chunk yang ditemukan dimasukkan ke prompt bersama instruksi seperti "Jawab hanya berdasarkan sumber di bawah ini dan sebutkan sumbernya." Model kemudian menulis jawaban yang berpijak pada data.
Mengapa banyak tim memilih RAG
Informasi selalu baru. Perbarui dokumen, dan jawabannya langsung ikut berubah tanpa perlu melatih ulang model.
Data pribadi tetap aman. File internal tetap tersimpan di penyimpananmu sendiri dan hanya diperlihatkan ke model saat dibutuhkan.
Jawaban karangan berkurang. Grounding mengurangi halusinasi, meski tidak menghilangkannya sepenuhnya. Artikel kami tentang mengapa chatbot bisa mengarang jawaban menjelaskan akar masalahnya.
Ada rujukan sumber. Pengguna bisa memeriksa sumbernya sehingga lebih percaya. IBM Research menyebut kemampuan diverifikasi ini sebagai salah satu manfaat utama RAG.
Tips membangun sistem RAG yang benar-benar berfungsi
Potong dokumen dengan cermat. Chunk yang terlalu kecil kehilangan konteks, sedangkan yang terlalu besar mengaburkan relevansi. Satukan judul dengan paragrafnya dan beri sedikit tumpang tindih antar-chunk.
Gabungkan pencarian kata kunci dan semantik. Embedding menangkap makna, tetapi bisa melewatkan istilah persis seperti kode produk. Hybrid search menambahkan metode kata kunci seperti BM25.
Tambahkan konteks pada setiap chunk. Riset Anthropic tentang Contextual Retrieval melaporkan bahwa menambahkan penjelasan singkat di awal setiap chunk mengurangi kegagalan pengambilan sebesar 49%, dan 67% bila dipadukan dengan reranking.
Urutkan ulang hasilnya. Ambil kumpulan hasil yang lebih luas dulu, lalu gunakan model reranking untuk menyisakan potongan yang paling relevan.
Izinkan jawaban "saya tidak tahu". Minta model berterus terang ketika sumber tidak memuat jawabannya. Prompt yang jelas sangat menentukan, jadi baca panduan kami tentang menulis prompt yang lebih baik dengan konteks, format, dan contoh.
Hormati hak akses. Saring dokumen yang diambil sesuai izin setiap pengguna, agar asisten tidak pernah membocorkan file yang dibatasi.
RAG, fine-tuning, atau konteks panjang?
Fine-tuning mengubah perilaku model, misalnya gaya bahasa atau format keluaran, tetapi kurang cocok untuk menyimpan fakta yang sering berubah. Jendela konteks yang sangat panjang memungkinkanmu menempelkan seluruh dokumen, tetapi memakan lebih banyak token di setiap permintaan. RAG berada di tengah: ia hanya mengirim potongan yang penting. Penjelasan RAG dari AWS menyebutnya sebagai cara hemat biaya untuk menjaga jawaban model tetap relevan dan akurat.
RAG tidak membuat model lebih pintar. RAG memastikan model membaca halaman yang tepat sebelum menjawab.
Jelajahi lebih lanjut
RAG sering menjadi lapisan pengetahuan di dalam asisten kecil yang fokus. Pelajari cara kami merancang agen AI kecil yang benar-benar berguna, atau temukan produk AI yang kami bangun di Ryuartistry.