Token AI Dijelaskan: Cara Model Bahasa Membaca Teks
Apa itu token, mengapa 1 token kira-kira setara 4 karakter bahasa Inggris, kaitannya dengan context window dan biaya, plus tips menghemat token di prompt.
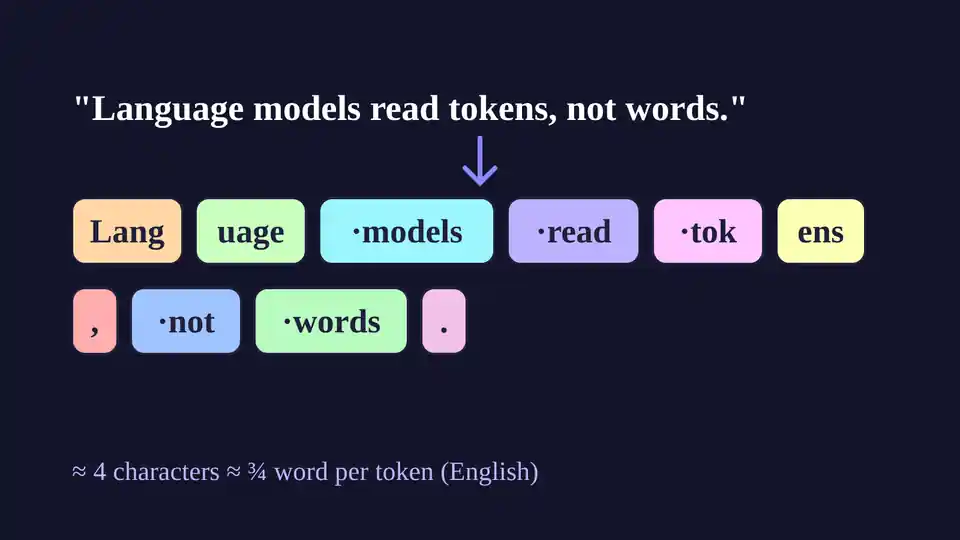
Saat kamu mengobrol dengan model AI, model tersebut tidak membaca pesanmu huruf demi huruf atau kata demi kata. Ia membaca token. Memahami token membantu menjelaskan mengapa model punya batas panjang, mengapa sebagian prompt lebih mahal daripada yang lain, dan mengapa kalimat yang sama bisa punya bobot berbeda di bahasa yang berbeda.
Apa itu token?
Token adalah potongan kecil teks yang diperlakukan model sebagai satu kesatuan. Token bisa berupa satu kata utuh ("read"), sebagian kata ("tok" + "ens"), tanda baca, atau kata beserta spasi di depannya. Sebelum model melihat teksmu, sebuah tokenizer memecahnya menjadi potongan-potongan ini lalu mengubah masing-masing menjadi angka.
Bagaimana teks dipecah
Sebagian besar model bahasa modern memakai metode subkata seperti byte pair encoding (BPE). Tokenizer mempelajari urutan karakter yang sering muncul di data latihnya dan memberinya token tersendiri. Kata yang umum menjadi satu token, sementara kata langka, nama, dan salah ketik dipecah menjadi beberapa token. Panduan tokenizer dari Hugging Face menjelaskan pendekatan-pendekatan utamanya.
Patokan praktis yang berguna
Untuk teks bahasa Inggris, OpenAI memperkirakan bahwa satu token kira-kira setara 4 karakter, atau sekitar tiga perempat kata. Artinya, 100 token setara dengan kurang lebih 75 kata. Kamu bisa melihat sendiri cara teks dipecah dengan OpenAI Tokenizer. Keluarga model lain memakai tokenizer yang berbeda, jadi anggap angka ini sebagai perkiraan, bukan tarif pasti.
Mengapa token penting
Context window
Setiap model memiliki context window, yaitu jumlah token maksimum yang bisa dipertimbangkan sekaligus. Anggaran ini mencakup prompt, dokumen yang dilampirkan, riwayat percakapan, dan jawaban model itu sendiri. Dokumentasi Anthropic tentang context window menjelaskan bagaimana input dan output berbagi ruang ini.
Biaya dan kecepatan
Sebagian besar API AI menagih biaya per token, sering kali dengan harga berbeda untuk input dan output. Token yang lebih banyak juga berarti komputasi lebih besar, sehingga prompt yang sangat panjang bisa lebih lambat dijawab.
Perbedaan antarbahasa
Tokenizer umumnya dilatih dengan data yang didominasi bahasa Inggris, sehingga bahasa lain sering butuh lebih banyak token untuk menyampaikan hal yang sama. Studi tahun 2023 berjudul "Language Model Tokenizers Introduce Unfairness Between Languages" menemukan bahwa teks yang sama, setelah diterjemahkan ke beberapa bahasa, bisa memakan token berkali-kali lipat dibanding versi bahasa Inggrisnya. Untuk konten berbahasa Indonesia, sebaiknya ukur langsung daripada menebak.
Tips menggunakan token dengan bijak
Spesifik, bukan panjang. Satu instruksi yang jelas lebih baik daripada tiga paragraf latar belakang.
Pangkas konteks yang berulang. Jangan menempelkan dokumen yang sama di setiap pesan dalam satu percakapan.
Minta format yang kamu butuhkan, misalnya "lima poin" atau "kurang dari 100 kata", agar jawaban tetap ringkas.
Bersihkan input. Hapus teks templat, teks menu, dan baris duplikat sebelum mengirim dokumen.
Ukur, jangan menebak. Jalankan contoh teks lewat tokenizer sebelum memperkirakan biaya.
Anggap token sebagai satuan perhatian model: setiap token yang kamu kirim harus punya alasan untuk ada.
Jelajahi lebih lanjut
Memahami cara kerja token memudahkanmu menulis prompt yang efektif. Lanjutkan dengan panduan kami tentang prompt yang lebih baik dengan konteks, format, dan contoh, dan lihat bagaimana instruksi yang ringkas menggerakkan agen AI kecil yang benar-benar berguna. Eksperimen AI lainnya bisa kamu temukan di Ryuartistry.